AI 모델 순위 비교
기준을 고르면 모델들이 값만큼 트랙을 달려 순위대로 자리 잡습니다. 정확한 값은 아래 순위표에서 확인하세요.
도구를 준비하고 있어요.
이 도구를 써 보셨나요? 쓰면서 느낀 점을 남겨 주시면 다음 사람에게 도움이 돼요.
AI 모델 순위 비교 상세 가이드
사용법과 예제를 살펴보고, 궁금한 내용은 주제별로 찾아보세요.
시작 전에 한눈에 보기
- 원자료
- 서버가 LiveBench 벤치마크와 OpenRouter 모델 정보를 하루 한 번 새로 받아 순위를 다시 매기고, 화면 위에 기준일을 적어요.
- 받지 못한 날
- 원자료를 받지 못하면 도구에 넣어 둔 순위(2026-11-12 기준)를 보여 주고 그 사실을 함께 알려요.
- 보여 주는 범위
- 트랙에는 상위 12개 모델이 달리고, 순위표는 기준마다 30위까지 보여 줘요. 측정 모델이 3개보다 적은 기준은 숨겨요.
- 기준 묶음
- 종합·분야별·가성비·속도·안정성·이미지·영상·음악 묶음이 있어요.
- 가격
- 입력 3 : 출력 1로 섞은 100만 토큰당 미국 달러예요. 원화 환산은 유럽중앙은행 기준환율로 바꾼 참고값이에요.
AI 모델 순위 비교 사용 순서
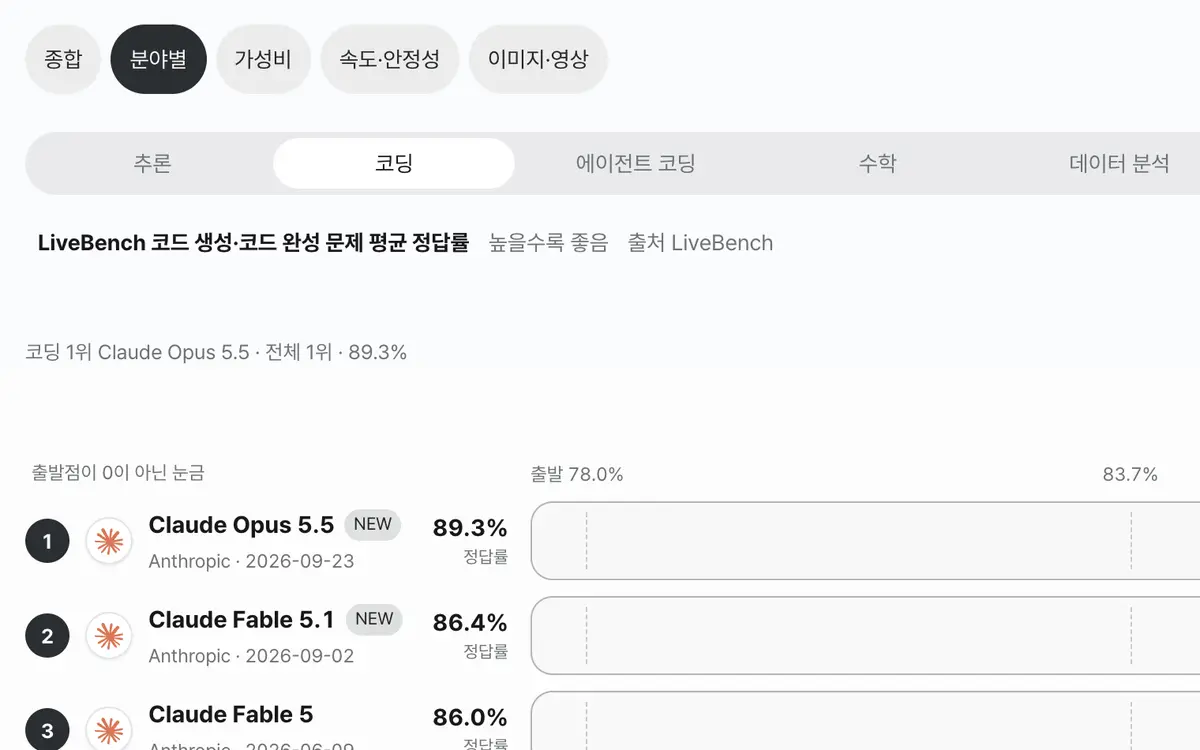
비교 기준 탭과 보고 싶은 회사를 고르세요
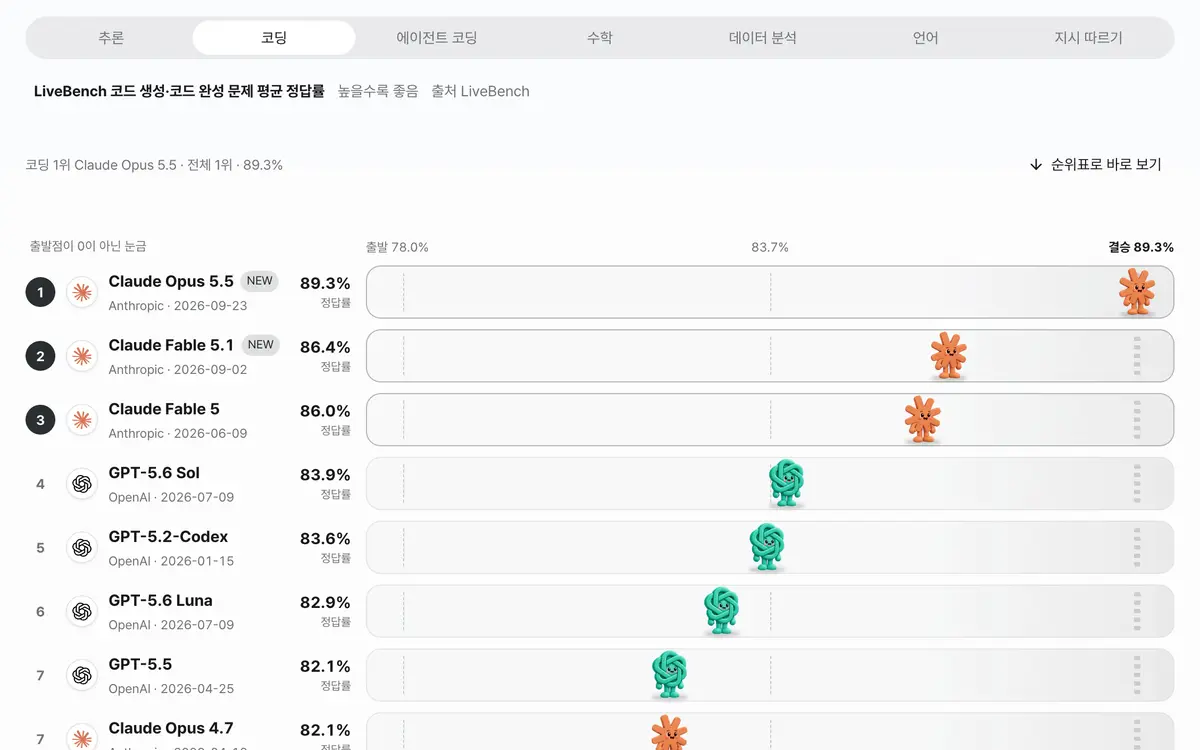
상위 12개 모델이 값만큼 달려 순위대로 자리 잡는 모습을 보세요
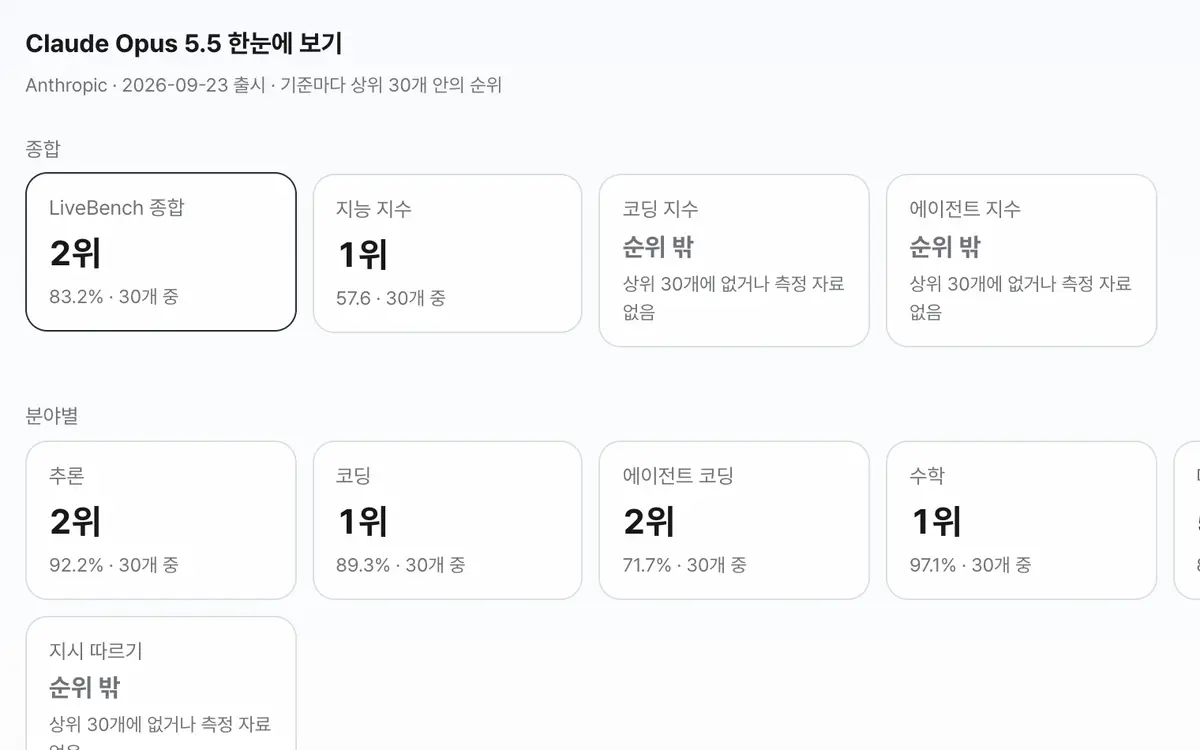
순위표에서 30위까지 보고, 모델 이름을 눌러 모든 기준의 순위를 모아 보세요
비교 기준을 고르세요
‘비교 묶음’에서 종합·분야별·가성비 등을 고르고 그 안의 기준 탭을 누르세요. 탭마다 무엇을 쟀는지와 ‘높을수록 좋음’ 같은 방향이 적혀요.
회사를 골라 보세요
‘회사별로 보기’에서 회사를 고르면 그 회사 모델만 남아요. 순위 번호는 전체 순위를 그대로 써요.
트랙을 읽으세요
상위 12개 모델이 값만큼 달려 순위대로 자리 잡아요. 트랙 위 눈금에 실제 값이 적혀 있으니 거리만 보지 말고 눈금을 함께 보세요.
순위표와 모델 요약을 보세요
순위표에서 ‘모두 보기’로 30위까지 펼치고, 모델 이름을 누르면 모든 기준의 순위를 한 번에 모아 봐요.
이런 작업에 활용하세요
종합·분야별·가성비·속도로 나눠 봅니다
종합에는 LiveBench 종합(LiveBench 2.0 일곱 분야의 가중 평균: 장기 에이전트 ×2, 코딩·디자인 ×1.5, 나머지 ×1)과 OpenRouter 가 제공하는 지능·코딩·에이전트 지수(Artificial Analysis 평가)가 있습니다. 분야별은 LiveBench 2.0 의 장기 에이전트·추론·코딩·브라우저 작업·데이터 분석·리서치·디자인입니다. 가성비는 LiveBench 과제 하나를 성공하는 데 든 비용과 100만 토큰당 가격, 속도·안정성은 OpenRouter 가 잰 출력 속도·첫 응답 시간·가동률·컨텍스트 길이입니다. 한 기준의 1위가 다른 기준에서도 앞선다는 뜻은 아니니 쓰려는 일에 맞는 기준을 보세요.
가성비 그래프 읽는 법
가로는 성공 1건당 비용, 세로는 점수입니다. 파란 점선은 같은 비용에서 그보다 점수가 높은 모델이 없는 모델만 이은 가성비 선입니다. 선 아래·오른쪽에 있는 모델은 더 싸면서 점수가 높은 대안이 있다는 뜻입니다.
트랙 눈금을 함께 읽어 주세요
점수 차이가 작은 기준은 트랙이 0 이 아니라 최솟값보다 조금 아래에서 출발해 차이를 크게 보여 줍니다. 가격과 컨텍스트는 수십 배 차이가 나서 로그 눈금을 씁니다. 트랙 위 눈금에 실제 값을 적어 두었으니 거리 차이를 그대로 배수로 읽지 마세요.
하루 한 번 새로 받습니다
원자료를 하루 한 번 새로 받아 순위를 다시 매기고 화면 위에 기준일을 적습니다. 벤치마크는 추론 강도(max·high 등) 설정에 따라 달라져 가장 높은 설정의 값을 표시했고, 가격은 입력 3 : 출력 1 비율로 섞은 100만 토큰당 미국 달러이고, 한국어 화면에서는 그날 유럽중앙은행 기준환율로 바꾼 원화 참고값(≈)을 옆에 적습니다. 실제 요금은 공급사와 할인 조건에 따라 다를 수 있습니다.
예제로 결과 이해하기
가격 탭 고르기
비교 묶음: 가성비 → 가격싼 모델일수록 결승선에 가까워요
트랙은 로그 눈금가성비 선 읽기
성공 1건당 비용과 점수
A $0.02·60점, B $0.05·55점
C $0.10·70점, D $0.40·68점가성비 선: A → C회사 하나만 보기
회사별로 보기: 한 회사 선택그 회사 모델만 남고 순위 번호는 전체 순위 그대로기준 묶음 고르기
표를 좌우로 밀어 나머지 내용을 확인하세요.
| 묶음 | 보는 것 | 출처 |
|---|---|---|
| 종합 | LiveBench 종합(일곱 분야의 가중 평균: 장기 에이전트 ×2, 코딩·디자인 ×1.5, 나머지 ×1)과 지능·코딩·에이전트 지수 | LiveBench, OpenRouter(Artificial Analysis 평가) |
| 분야별 | 장기 에이전트·추론·코딩·브라우저 작업·데이터 분석·리서치·디자인(LiveBench 2.0 일곱 분야) | LiveBench |
| 가성비 | 성공 1건당 비용과 100만 토큰당 가격 | LiveBench, OpenRouter |
| 속도·안정성 | 출력 속도·첫 응답·가동률·컨텍스트 길이 | OpenRouter |
결과가 예상과 다를 때
‘내장 자료’라고 나와요
그날 원자료를 받지 못해 도구에 넣어 둔 순위를 보여 주는 중이에요. 표시된 기준일을 확인하고 나중에 다시 열어 보세요.
찾는 모델이 ‘순위 밖’이에요
기준마다 상위 30개만 담아요. 그 기준을 재지 않았거나 30위 밖이면 요약에 ‘상위 n개에 없거나 측정 자료 없음’으로 나와요.
고른 회사 모델이 없다고 나와요
그 기준 순위에 해당 회사 모델이 없어서예요. 다른 기준이나 회사를 골라 보세요.
알아두면 쉬운 용어
- LiveBench
- AI 모델을 여러 분야 과제로 채점해 공개하는 벤치마크예요. 이 도구는 LiveBench 2.0 의 일곱 분야 점수를 써요.
- 로그 눈금
- 값이 열 배씩 커질 때 같은 거리만큼 나아가는 눈금이에요. 가격·컨텍스트처럼 차이가 큰 값에 써요.
- 가성비 선
- 같은 비용으로 더 높은 점수를 낸 모델이 없는 모델들을 이은 선이에요.
AI 모델 순위 비교 자주 묻는 질문
순위는 언제 기준인가요?
화면 위에 적힌 기준일입니다. 서버가 LiveBench·OpenRouter 원자료를 하루 한 번 새로 받으므로, 새 모델은 원자료에 실린 뒤 늦어도 하루 안에 반영됩니다. 원자료를 받지 못한 날에는 도구에 넣어 둔 순위와 그 기준일을 보여 드립니다.
가격 1위는 무슨 뜻인가요?
100만 토큰을 입력 3 : 출력 1 비율로 썼을 때 가장 싼 모델입니다. 가격 탭은 쌀수록 결승선에 가깝습니다.
로고와 캐릭터는 공식인가요?
아닙니다. 로고와 캐릭터는 각 회사의 상표를 가리키려고 쓴 것이며 UtilPick 은 각 회사와 관계가 없고 후원이나 보증을 받지 않았습니다.
모델 이름을 누르면 무엇이 나오나요?
그 모델이 기준마다 몇 위인지 모은 요약 창이 열려요. 상위 30개에 없는 기준은 순위 밖으로 표시돼요.
속도·첫 응답 탭이 안 보일 때가 있어요.
측정한 모델이 3개보다 적은 기준은 순위라 부르기 어려워 숨겨요. 원자료가 다시 채워지면 나타나요.


