本文へ移動
UtilPick.
マイツール
すべての道具
お気に入り
保存した道具

読み込み中…

最近使った道具

開いた道具がここに表示されます。

デスクトップ版を入れる
設定
UtilPick.
すべての道具
すべての道具/AIモデルランキング比較

AIモデルランキング比較

AIモデルを分野別スコア・コスパ・速度で比較。LiveBenchとOpenRouterのデータを毎日更新し基準日も表示。画像・動画生成AIの順位もあります。

ツールを準備しています。

このツールを使ってみましたか?感想を残していただくと、次に使う人の役に立ちます。

ユーザーレビュー

まだレビューはありません。

レビューを書く

ログイン状態を確認しています。

    使い始めから結果の確認まで

    AIモデルランキング比較の詳しい使い方ガイド

    使い方と例を確認し、知りたいことはトピックから探せます。

    使い方
    例と選び方
    トラブル解決
    よくある質問

    はじめに確認すること

    元データ
    サーバーがLiveBenchのベンチマークとOpenRouterのモデル情報を1日1回新しく取得して順位を付け直し、画面の上に基準日を表示します。
    取得できなかった日
    元データを取得できないときは、ツールに組み込んだ順位(2026-11-12時点)を表示し、そのことをお知らせします。
    表示する範囲
    トラックには上位12モデルが走り、順位表は基準ごとに30位まで表示します。測定したモデルが3つより少ない基準は非表示にします。
    基準のグループ
    総合・分野別・コスパ・速度・安定性・画像・動画・音楽のグループがあります。
    価格
    入力3:出力1で混ぜた100万トークンあたりの米ドルです。韓国ウォンへの換算は、欧州中央銀行の基準レートで換算した参考値です。

    AIモデルランキング比較の使い方
    1. 1. 比較する指標のタブと見たい企業を選びます

      01比較する指標のタブと見たい企業を選びます

    2. 2. 上位12モデルが値のぶんだけ走って順位の位置に収まる様子を見ます

      02上位12モデルが値のぶんだけ走って順位の位置に収まる様子を見ます

    3. 3. 順位表で30位まで確認し、モデル名を押すと全指標の順位をまとめて見られます

      03順位表で30位まで確認し、モデル名を押すと全指標の順位をまとめて見られます

    1. 01

      比較する基準を選びます

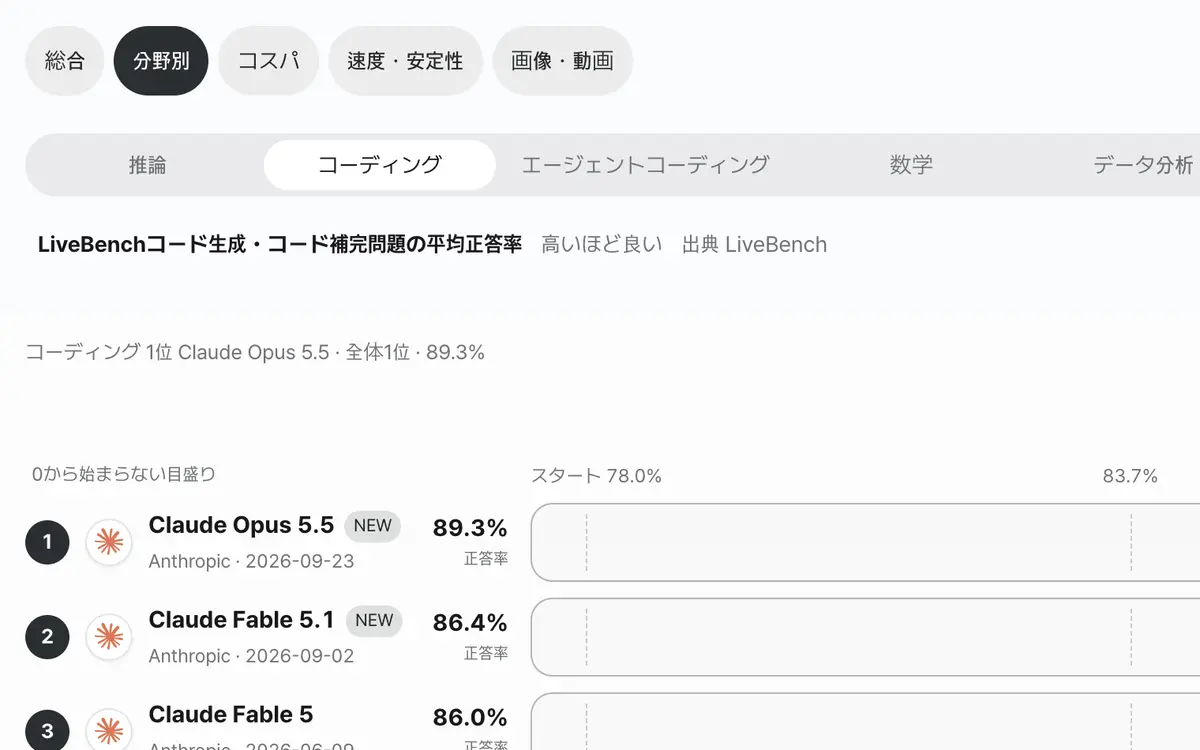
      「比較グループ」で総合・分野別・コスパなどを選び、その中の基準のタブを押してください。タブごとに、何を測ったかと「高いほど良い」などの向きが書かれています。

    2. 02

      会社を選びます

      「会社別に見る」で会社を選ぶと、その会社のモデルだけが残ります。順位の番号は全体の順位をそのまま使います。

    3. 03

      トラックを読みます

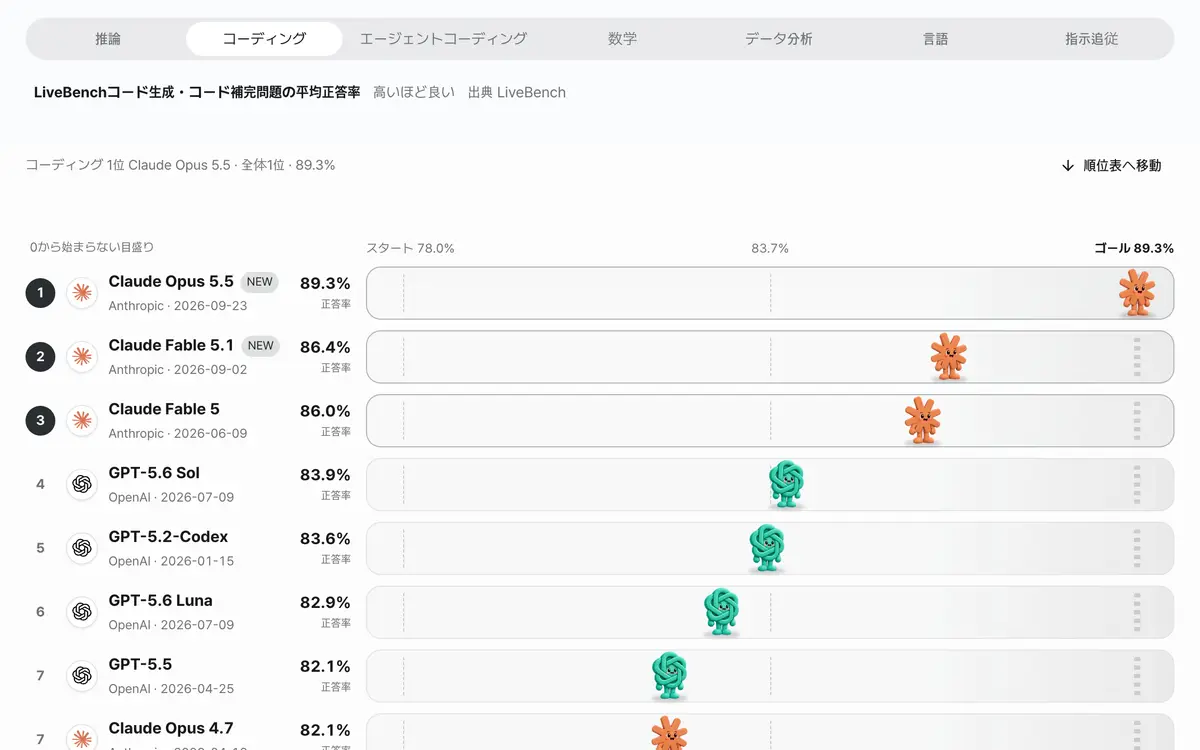
      上位12モデルが値に応じて走り、順位どおりに並びます。トラックの上の目盛りに実際の値が書いてあるので、距離だけでなく目盛りもあわせて見てください。

    4. 04

      順位表とモデルの要約を見ます

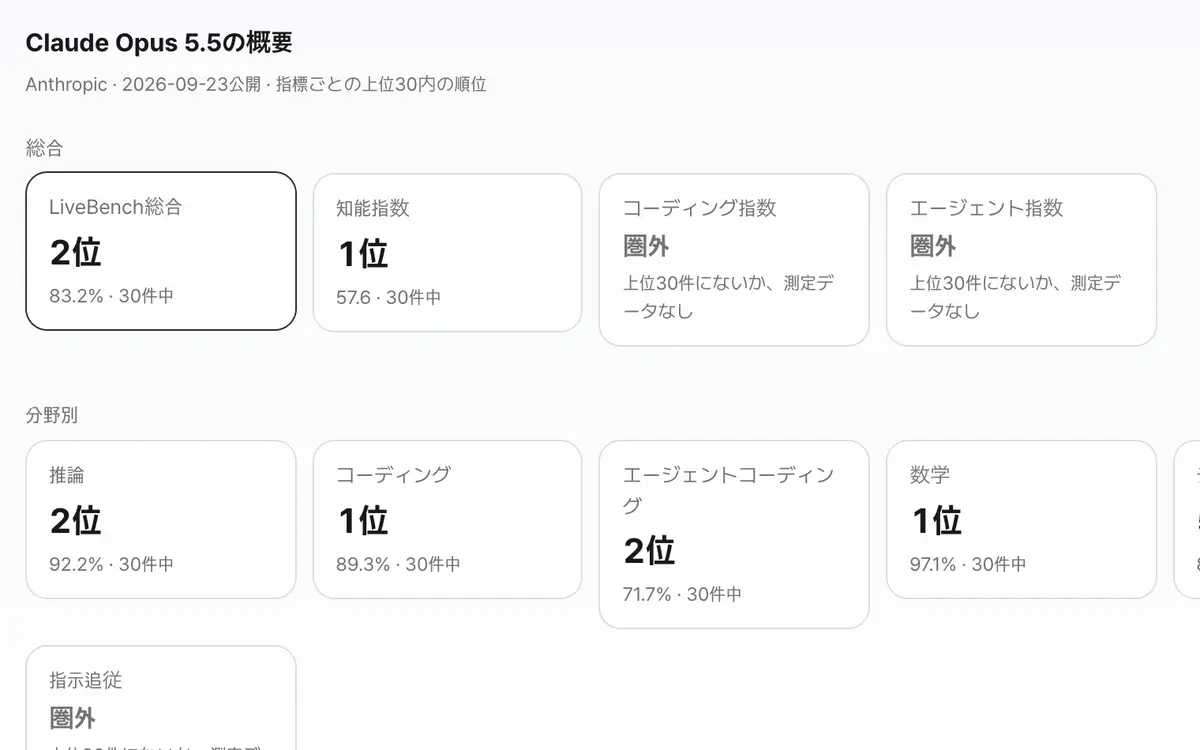
      順位表で「すべて表示」を押すと30位まで広がり、モデル名を押すと、すべての基準での順位をまとめて見られます。

    こんな作業に使えます

    総合・分野別・コスパ・速度に分けて見ます

    総合には、LiveBenchの総合スコア(LiveBench 2.0の7つの分野の加重平均で、長期エージェント×2、コーディングとデザイン×1.5、残りは×1)と、OpenRouterが提供する知能・コーディング・エージェント指数(Artificial Analysisによる評価)があります。分野別は、LiveBench 2.0の長期エージェント・推論・コーディング・ブラウザ作業・データ分析・リサーチ・デザインです。コスパは、LiveBenchの問題1問を正解するのにかかった費用と100万トークンあたりの価格、速度・安定性は、OpenRouterが測った出力速度・最初の応答までの時間・稼働率・コンテキスト長です。1つの基準で1位でも、別の基準でも上位とは限らないので、使いたい用途に合う基準を見てください。

    コスパのグラフの読み方

    横軸は成功1件あたりの費用、縦軸はスコアです。青い点線は、同じ費用でそれより高いスコアのモデルがないモデルだけを結んだコスパの線です。線の下側・右側にあるモデルには、より安くてスコアが高い代替モデルがあることを意味します。

    トラックの目盛りもあわせて読んでください

    スコアの差が小さい基準では、トラックが0ではなく最小値より少し下から始まり、差を大きく見せます。価格とコンテキスト長は数十倍の差があるため、対数目盛りを使っています。トラックの上の目盛りに実際の値が書いてあるので、距離の差をそのまま倍率として読まないでください。

    1日1回、新しく取得します

    元データを1日1回新しく取得して順位を付け直し、画面の上に基準日を表示します。ベンチマークは推論強度(maxやhighなど)の設定によって変わるため、最も高い設定の値を表示しています。価格は入力3:出力1の比率で混ぜた100万トークンあたりの米ドルで、韓国語の画面では、その日の欧州中央銀行の基準レートで換算した韓国ウォンの参考値(≈)を横に表示します。実際の料金は、提供会社や割引条件によって異なる場合があります。

    例で結果を確かめる

    価格のタブを選ぶ

    入力・設定
    比較グループ:コスパ → 価格
    結果
    安いモデルほどゴールに近くなります
    トラックは対数目盛り
    価格は低いほど良い基準です。値の差が大きいため対数目盛りで描いており、距離を倍率として読まないでください。

    コスパの線を読む

    入力・設定
    成功1件あたりの費用とスコア
    A $0.02・60点、B $0.05・55点
    C $0.10・70点、D $0.40・68点
    結果
    コスパの線:A → C
    安い順に見ていき、それまでのどのモデルよりもスコアが高いモデルだけを残します。BはAより高くてスコアが低く、DはCより高くてスコアが低いため、線から外れます。

    1社だけを見る

    入力・設定
    会社別に見る:1社を選択
    結果
    その会社のモデルだけが残り、順位の番号は全体の順位のまま
    会社の中で1位でも、全体では何位なのかをあわせて表示するため、大げさにならずに比べられます。

    基準のグループの選び方

    表を左右にスクロールすると続きが見られます。

    基準のグループの選び方
    グループ見るもの出典
    総合LiveBenchの総合(7分野の加重平均:長期エージェント×2、コーディング・デザイン×1.5、残り×1)と、知能・コーディング・エージェント指数LiveBench、OpenRouter(Artificial Analysisによる評価)
    分野別長期エージェント・推論・コーディング・ブラウザ作業・データ分析・リサーチ・デザイン(LiveBench 2.0の7分野)LiveBench
    コスパ成功1件あたりの費用と、100万トークンあたりの価格LiveBench、OpenRouter
    速度・安定性出力速度・最初の応答・稼働率・コンテキスト長OpenRouter

    結果が思ったとおりにならないとき

    「内蔵データ」と表示されます

    その日は元データを取得できなかったため、ツールに組み込んでおいた順位を表示しています。表示されている基準日を確認して、後でもう一度開いてみてください。

    探しているモデルが「順位圏外」です

    基準ごとに上位30件だけを収めています。その基準で測っていないか、30位より下の場合は、要約に「上位n件にない、または測定データなし」と表示されます。

    選んだ会社のモデルがないと表示されます

    その基準の順位に、該当する会社のモデルがないためです。別の基準や会社を選んでみてください。

    知っておきたい用語

    LiveBench
    AIモデルをいくつもの分野の課題で採点して公開するベンチマークです。このツールはLiveBench 2.0の7分野のスコアを使います。
    対数目盛り
    値が10倍になるごとに同じ距離だけ進む目盛りです。価格やコンテキスト長のように、差が大きい値に使います。
    コスパの線
    同じ費用でより高いスコアを出したモデルがないモデルを結んだ線です。

    AIモデルランキング比較のよくある質問

    順位はいつの時点のものですか?

    画面の上に表示されている基準日のものです。サーバーがLiveBenchとOpenRouterの元データを1日1回新しく取得するため、新しいモデルは元データに載ってから遅くとも1日以内に反映されます。元データを取得できなかった日は、ツールに組み込んでおいた順位とその基準日を表示します。

    価格で1位とはどういう意味ですか?

    100万トークンを入力3:出力1の比率で使ったときに、最も安いモデルです。価格のタブでは、安いほどゴールに近くなります。

    ロゴやキャラクターは公式のものですか?

    いいえ。ロゴとキャラクターは、各社の商標を指し示すために使っているもので、UtilPickは各社と関係がなく、後援や保証を受けていません。

    モデル名を押すと何が表示されますか?

    そのモデルが基準ごとに何位かをまとめた要約ウィンドウが開きます。上位30件に入っていない基準は、順位圏外と表示されます。

    速度・最初の応答のタブが表示されないことがあります。

    測定したモデルが3つより少ない基準は、順位と呼びにくいため非表示にします。元データが再び補充されると表示されます。

    知りたいトピックへ移動

    • #AIモデル比較
    • #基準グループ
    • #コスパの線
    • #内蔵データ

    内容確認 2026.11.12

    あわせて使えるツール

    すべて見る
    グラフ画像作成時間・仕事
    文字数カウントテキスト
    単価比較お金・計算
    UtilPick

    忙しい毎日に、シンプルな道具をひとつ。無料のオンラインツール集。

    サービス

    UtilPick について デスクトップ版を入れる

    サポート

    道具をリクエスト不具合を知らせるお問い合わせinfo@utilpick.com

    ポリシー

    プライバシーポリシー(韓国語)利用規約(韓国語)
    事業者登録番号 365-47-00936(大韓民国)
    © 2026 UtilPick
    Featured on Twelve ToolsUtilPick - Featured on Startup FameFazier badgeFeatured on LaunchIgniter
    ホーム検索お気に入りその他

    今日の1位

    • 今日の変化…
    01

    モデル順位レース

    最新の順位を取得しています

    LiveBench総合
    知能指数
    コーディング指数
    エージェント指数
    LiveBench 2.0の7分野スコアを、LiveBenchが定めた重みで平均した値(現在は長期エージェント×2、コーディング・デザイン×1.5、その他×1)高いほど良い出典 LiveBench

    LiveBench総合 1位 Claude Fable 5.2 · 全体1位 · 84.9%

    0から始まらない目盛り
    スタート 63.0%74.0%ゴール 84.9%
    3
    Claude Fable 5.1Anthropic · 2026-09-02
    84.0%加重平均スコア
    1
    Claude Fable 5.2NEWAnthropic · 2026-11-10
    84.9%加重平均スコア
    12
    Claude Haiku 5.5Anthropic · 2026-10-08
    68.9%加重平均スコア
    5
    Claude Opus 5.5Anthropic · 2026-09-23
    83.4%加重平均スコア
    9
    Claude Sonnet 5.5Anthropic · 2026-09-29
    77.0%加重平均スコア
    11
    DeepSeek V4.1 Flash 1017NEWDeepSeek · 2026-10-17
    70.3%加重平均スコア
    8
    Gemini 4 ArgonNEWGoogle DeepMind · 2026-10-14
    77.7%加重平均スコア
    4
    Gemini 4 CarbonNEWGoogle DeepMind · 2026-11-11
    83.5%加重平均スコア
    2
    GPT-6 AstraOpenAI · 2026-09-05
    84.5%加重平均スコア
    6
    GPT-6.1 SolOpenAI · 2026-09-30
    81.4%加重平均スコア
    7
    GPT-6.1 TerraNEWOpenAI · 2026-10-27
    78.8%加重平均スコア
    10
    Muse WonderMeta AI · 2026-10-12
    70.7%加重平均スコア

    今日の変化

    毎日取得した順位を集めて前日と比べます

    今日から順位の収集を始めました。明日から、前日と比べた上昇・下降と新しく入ったモデルがここに表示されます。

    コスパ早見

    LiveBenchの問題を解いたときの実際のコストで評価したコスパです。分野を切り替えられます。

    青い点線(コスパ線)上のモデルは、同じコストでそれより高いスコアを出したモデルがありません。点を押すとそのモデルの概要を見られます。
    総合 · 成功あたりコストが安い順
    1. $0.13 · 60.4点
    2. $0.17 · 63.7点
    3. $0.17 · 60.7点
    4. $0.18 · 42.3点
    5. $0.18 · 66.1点
    6. $0.19 · 70.3点
    7. $0.22 · 32.4点
    8. $0.31 · 47.0点
    02

    順位表

    LiveBench 2.0の7分野スコアを、LiveBenchが定めた重みで平均した値(現在は長期エージェント×2、コーディング・デザイン×1.5、その他×1) · 高いほど良い · モデル名を押すとすべての指標をまとめて見られます

    表を横にスワイプすると残りの列が見られます。

    LiveBench総合によるAIモデル順位、2026-11-12時点
    順位モデル企業加重平均スコア公開日
    1 NEWAnthropic84.9%2026-11-10
    2OpenAI84.5%2026-09-05
    3Anthropic84.0%2026-09-02
    4 NEWGoogle DeepMind83.5%2026-11-11
    5Anthropic83.4%2026-09-23
    6OpenAI81.4%2026-09-30
    7 NEWOpenAI78.8%2026-10-27
    8 NEWGoogle DeepMind77.7%2026-10-14
    9Anthropic77.0%2026-09-29
    10Meta AI70.7%2026-10-12
    11 NEWDeepSeek70.3%2026-10-17
    12Anthropic68.9%2026-10-08
    基準・出典を見る
    基準日
    2026-11-12 · 元データを1日1回取得し、順位を付け直しています
    出典
    • LiveBench.AILiveBench 2.0総合、長期エージェント・推論・コーディング・ブラウザ操作・データ分析・リサーチ・デザイン、成功あたりコストとコスパグラフ、テキストAIリプレイ
    • OpenRouter提供価格・コンテキスト長、直近1日の稼働率、直近30分の出力速度・初回応答時間、知能・コーディング・エージェント指数(Artificial Analysis評価)
    • Artificial Analysis画像生成・画像編集・動画生成・画像→動画・音楽(ボーカル)・音楽(インスト)のアリーナEloスコア
    トラックの見方
    トラックでは上位12モデルが走り、残りは順位表の「すべて表示」で見られます。スコア系の指標は差が見えるよう最小値より少し下から始まります。価格・コンテキストは対数目盛りです。距離を倍率として読まず、目盛りの値もあわせて見てください。
    測定条件
    ベンチマークはモデルごとに最も高い推論強度(max・xhigh・high)の値で、価格は入力3:出力1で混ぜた100万トークンあたりの米ドルです。LiveBench総合は7分野のスコアをLiveBenchが公開ごとに定めた重みで平均し、分野が1つでも欠けると総合を付けません。成功あたりコストはLiveBenchサイトと同じ(課題あたりコスト÷スコア)×100です。公開日はOpenRouterに登録された日で、OpenRouterにないモデルは空欄にしています。NEWは基準日から30日以内に出たモデルです。画像・動画・音楽は人々が2つの結果を比べて選んだ投票によるEloスコアなので、数十点以内の差は実質的に同程度です。Artificial Analysisが公開日を知らせないため、これらの指標には公開日とNEWを表示しません。
    商標について
    ロゴとキャラクターは各社の商標を示すもので、商標権は各社に帰属します。UtilPickは各社と関係がなく、後援や保証を受けていません。ロゴアイコン: Lobe Icons (MIT).
    ほかのAIランキング画像生成AIランキング比較動画生成AIランキング比較音楽生成AIランキング比較(Sunoなど作曲AI)